Caderno Mandem
Mandem in Disguise AI: o que muda antes e depois do flash
O contraste faz a piada funcionar: uma cena comum, um flash e as mesmas pessoas de balaclava e jaqueta acolchoada. Observe a preparação antes de criar sua versão.
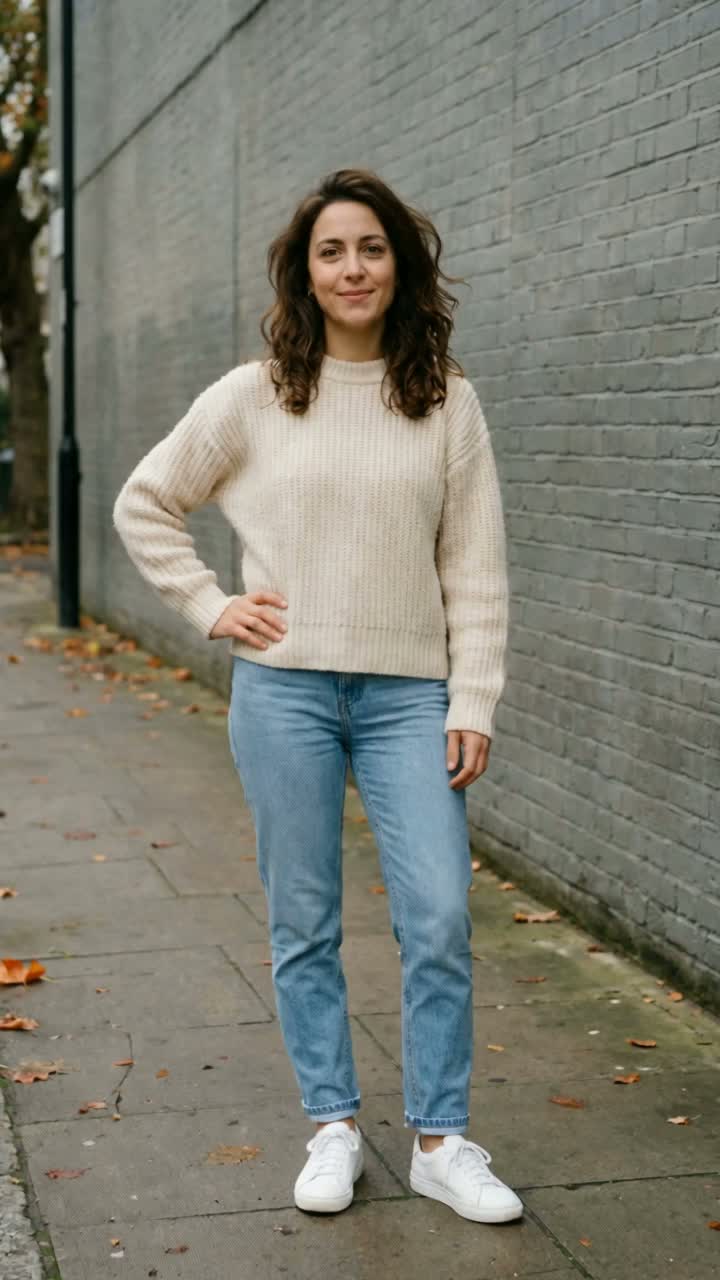 Antes do flash
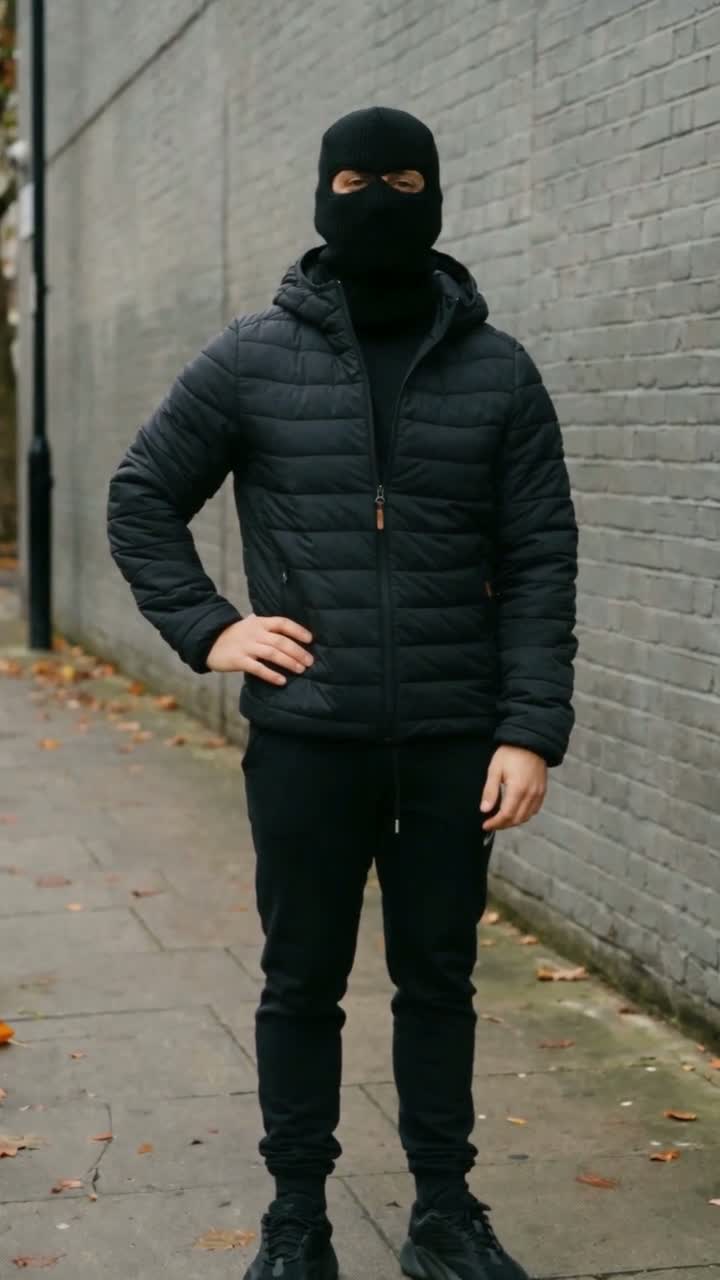 Depois do flash
Três momentos para construir a surpresa
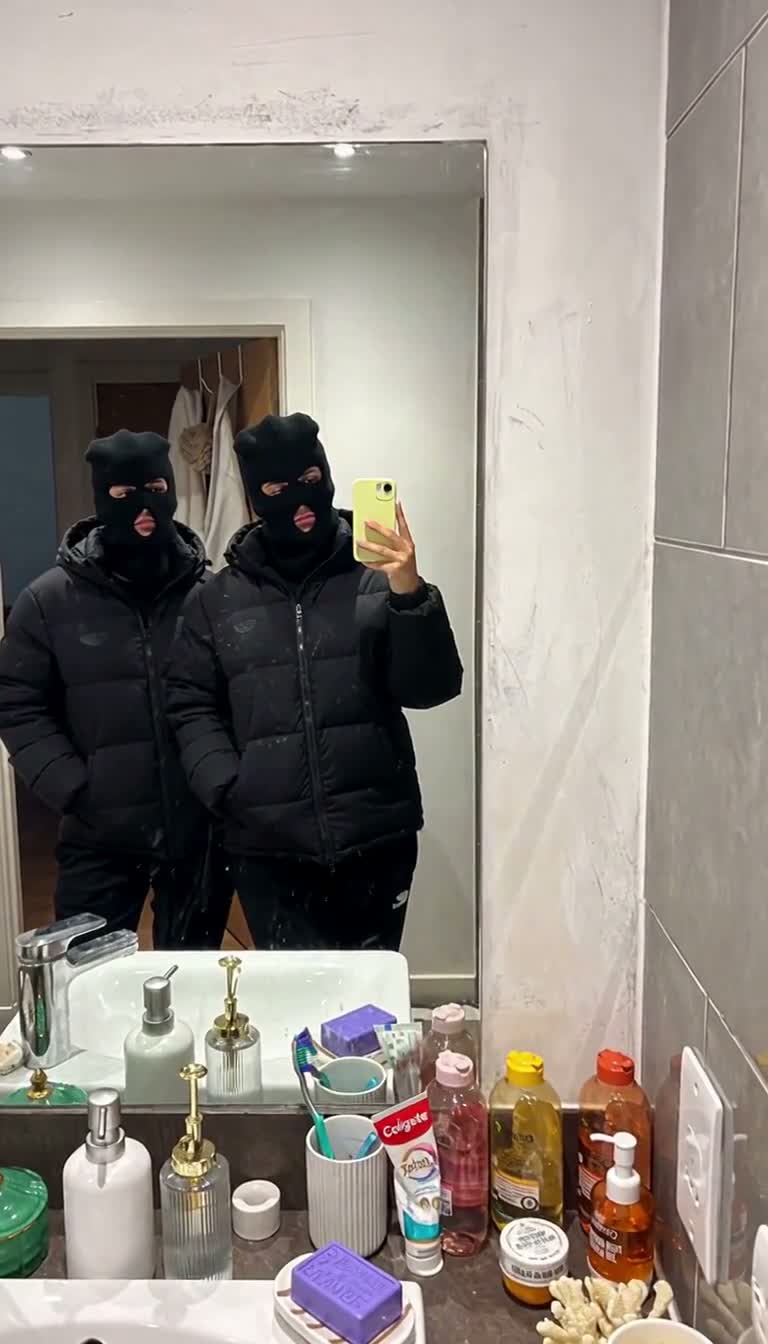
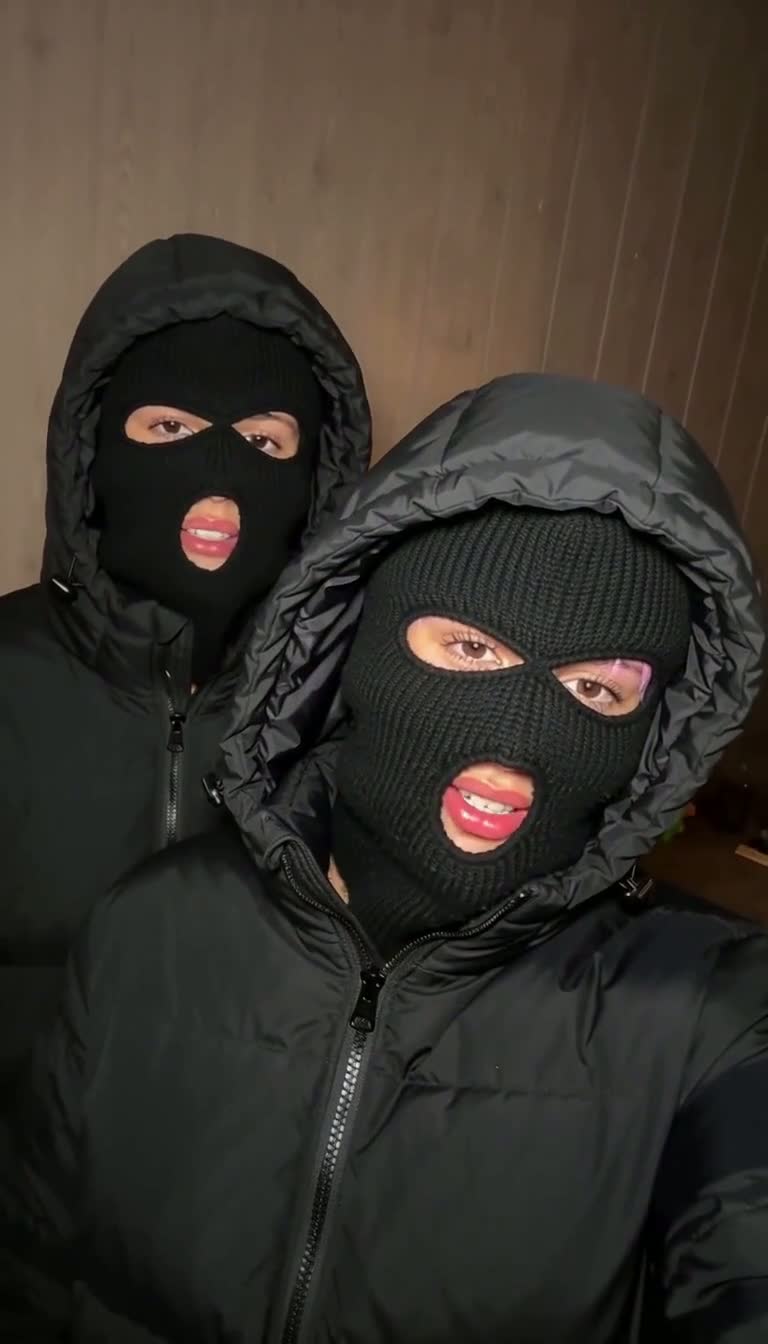
O início estabelece uma composição reconhecível. No espelho, duas pessoas ficam lado a lado; no close, uma está à frente da outra. Isso ajuda o público a lembrar a cena original.
O clarão esconde a troca de roupa. Depois, posições e reações precisam continuar legíveis. Uma cena sem relação com o começo perde a continuidade da transformação.
Escolha a cena, não só a capa
Solo é para uma pessoa. Mirror selfie mostra duas diante do espelho, com o celular à direita. Close-up flash coloca uma pessoa à direita em primeiro plano e outra atrás à esquerda.
As referências das duplas duram cerca de 12 segundos; o vídeo personalizado do estúdio tem 10. A duração no player é a do exemplo, não uma promessa de reproduzir cada quadro.
Fotos e vídeo têm funções diferentes
As fotos fornecem as identidades; o vídeo orienta cenário, posições e movimentos. Na dupla, envie dois retratos individuais, em Left person e Right person. Não é necessário tirar uma foto juntos.
A documentação da Replicate descreve referências numeradas de imagem e vídeo para Seedance 2.0. Usamos esse formato, mas a consistência facial continua sendo um resultado generativo, sem garantia de troca literal perfeita.
Confira o começo e o final
Pause antes do flash e confira cada rosto. Depois compare olhos, proporções e posições. Na dupla, observe se as identidades trocaram de lugar ou se alguém desapareceu.
Os clipes são referências do modelo, não resultados de clientes nem evidência de taxa de sucesso. Não atribuímos números de visualizações ou promessas de viralização sem comprovação.
Assistir à referência
Fontes e referências
A geração pode alterar identidades, movimentos e áudio. Confira o resultado antes de compartilhar.